大量の売買ルールから最良の一本を選んだとき、その好成績が探索の偶然ではないかを問うのがWhite Reality Check(RC)である。しかし実務では、探索数を補正するだけでは足りない。比較対象を現金にするか現行戦略にするか、明らかに負ける候補をどう扱うか、系列依存をどこに反映するかで、同じバックテストでも検定の意味が変わる。本稿ではRCの基本を踏まえ、HansenのSPAと比較しながら、研究用の損益表を検定可能な形へ整える。

ベンチマークは「何の代替になるか」で決める
ベンチマークとは優位性を測る基準である。損失を小さいほど良い量として、時点tの候補kと基準の差を dk,t=L0,t−Lk,t と置く。損失を費用控除後リターンの符号反転で定義すれば、差は候補リターン−基準リターンになる。正なら候補が良い。帰無仮説は「全候補の期待差がゼロ以下」、対立仮説は「少なくとも一つは正」である。一本ずつの勝敗ではなく、探索集合全体についての問いだ。
現金との比較は資金を市場へ出す価値を、買い持ちとの比較は市場への単純な参加を超える価値を、現行戦略との比較は入れ替える価値を問う。たとえば株価指数の順張り候補を現金とだけ比較すると、株式市場の上昇を拾った成果と売買タイミングの成果が混ざる。現行戦略の改善が目的なのに基準をゼロに置けば、運用判断には答えていない。
基準と候補では、評価時刻、元本、資金拘束、手数料、スリッページ、資金調達費をそろえる。ボラティリティ目標を使うなら、その推定は当時利用可能な情報だけで行う。全期間の実現変動率で倍率を後から調整すると、比較条件へ未来情報が入る。損益額で比べる場合も、候補だけレバレッジを増やして勝つ設計を避けるため、許容リスクと資本配分規則を先に書いておく。
基準そのものを複数試し、最も勝ちやすい基準だけを報告するのも別の探索である。主比較を現行戦略、補助比較を現金と買い持ち、と役割を固定し、補助比較を主比較の不合格を覆す材料にしない。超過平均を主指標にするなら、検定後にシャープ比や最大ドローダウンへ主指標を切り替えない。これらは別途、運用可能性の点検として並記する。
RCとSPAは、同じ問いに異なる帰無分布を作る
nを共通の評価観測数、d̄kを候補kの平均差とする。図のRCは基本の非標準化版で、TRC=maxk√n d̄k。再標本側では平均差から元の平均差を引き、T*RC=maxk√n(d̄*k−d̄k)を作る。これは全候補の期待差をゼロとした境界で比較する設計である。探索全体の最大値を帰無分布側にも作る点が、選んだ一本だけの通常検定との違いになる。根拠はWhite(2000)の原論文にある。
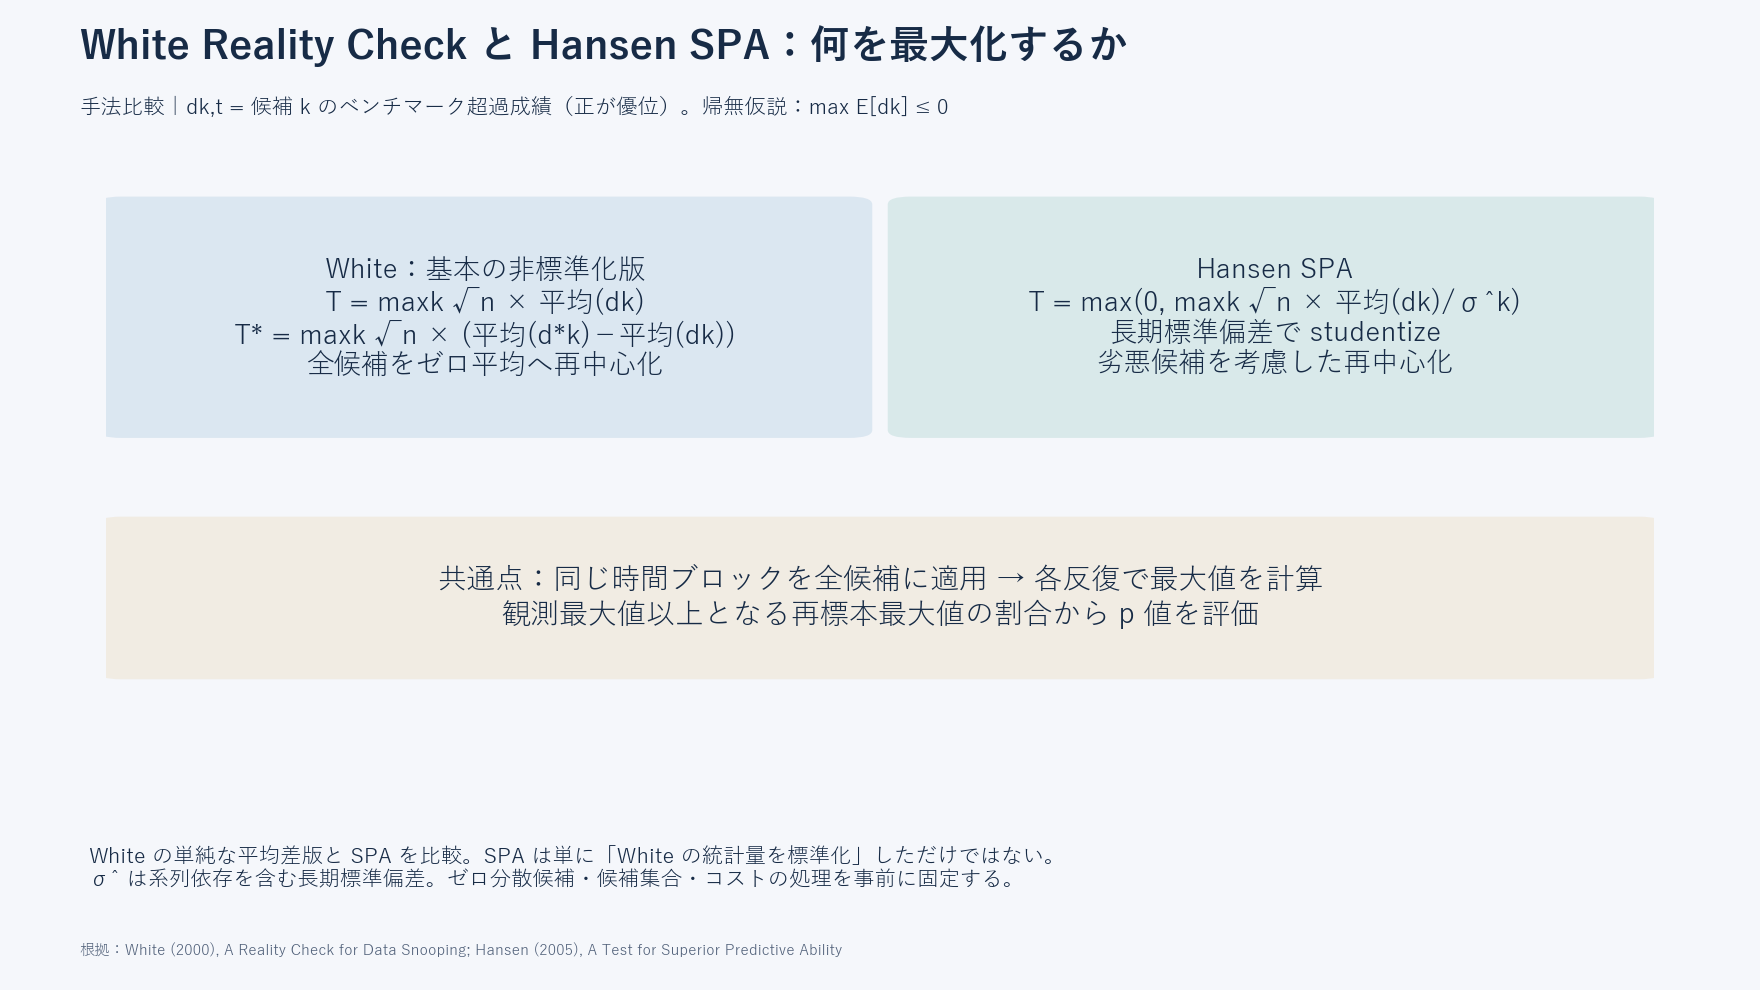
SPAはTSPA=max(0, maxk√n d̄k/σ̂k)を用いる。studentizationとは、不確実性の大きさで各候補の平均差を割り、比較の尺度をそろえる操作だ。ただし「RCを標準化したらSPAになる」わけではない。SPAは帰無分布の中心もデータに応じて変える。この二つを分けて考えると、結果が違った理由を調べやすい。Hansen(2005)の原論文、第2・3節がその設計を説明している。
劣悪モデルが有望候補を見えにくくする仕組み
検出力とは、本当に優位な候補があるときに帰無仮説を棄却できる確率である。RCで負の平均差を持つ候補までゼロへ移すと、本来は最大値競争から遠い候補が、帰無分布では同点の挑戦者として扱われる。特に揺れの大きい劣悪候補は、再標本化の偶然で大きな正の値を出せる。その最大値の右裾が厚くなれば、有望候補が越えるべき壁も高くなる。
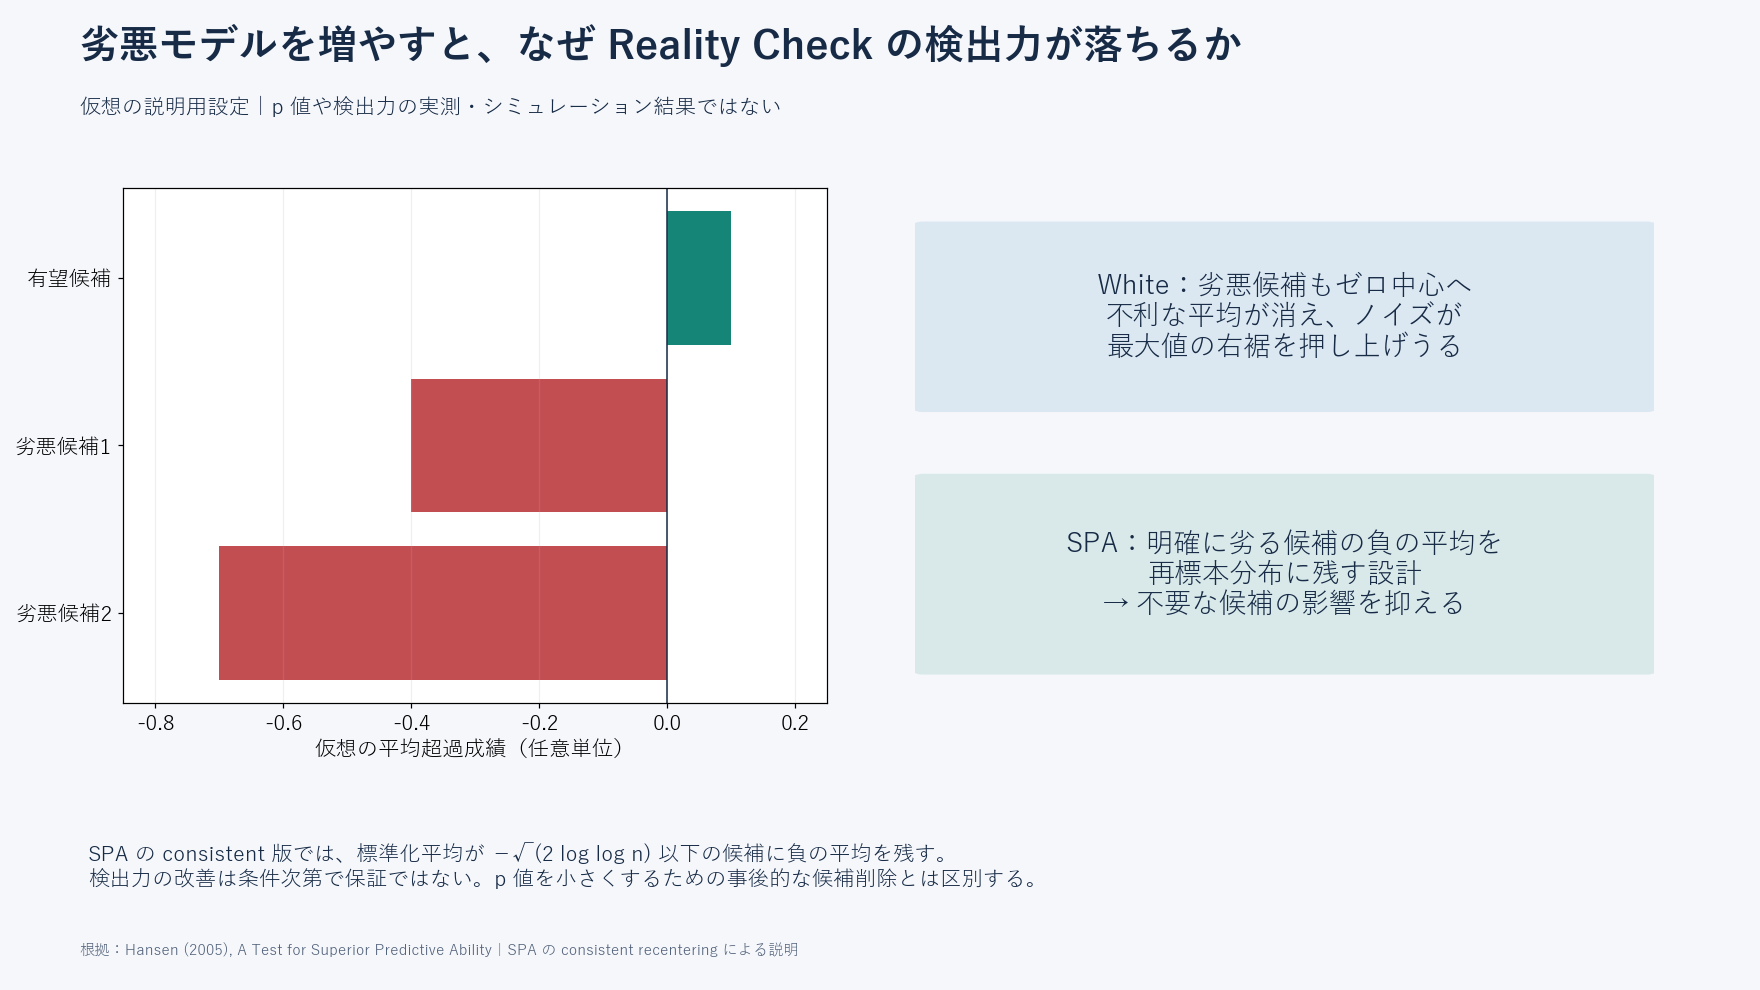
図の0.1、−0.4、−0.7は任意単位の説明値で、実際の市場推定値ではない。負の棒があるだけでは検出力の低下量は分からず、分散や候補間相関も必要になる。同じ損益を複製した候補を追加する場合と、別のノイズを持つ候補を追加する場合も違う。「候補が増えれば必ず同じだけ不利」という単純な数え方ではない。
ここで実務上やってはいけないのは、結果を見て負けた候補を手で除き、残った集合にRCをかけ直して有意な方を採ることだ。削除規則自体が新しい探索になる。生成に失敗した設定や未来情報を含む設定の排除は必要だが、その理由は成績の良し悪しと分離する。仕様上有効な候補は探索台帳に残し、劣悪候補への対応はSPAの定義済みの処理に任せる。
長期分散は「一日の損益のばらつき」ではない
SPAのσ̂kは、√n倍した平均差の長期標準偏差を推定する。理論上の長期分散はγk(0)+2Σh≥1γk(h)で、γ(h)はh期離れた差の自己共分散である。同じポジションを数日持つ戦略では、日次差が続けて同じ方向へ動くことがある。一日分の標本標準偏差だけで割ると、その連続性による平均の不確実性を落としてしまう。
実装ではHAC型の推定やstationary bootstrapに対応した分散推定などを使い、ラグの重みや依存パラメータを記録する。再標本平均の分散から求めるなら、推定したいのは平均そのものの分散ではなく、そのn倍である。ここでnを掛け忘れると、標準化統計量の尺度が変わる。年率換算した損益と日次単位の分散を組み合わせる事故にも注意したい。
候補と基準それぞれの分散を推定して単純に足すのではなく、まず差系列を作る。両者が同じ相場要因で動く共分散が、差の不確実性に含まれるからだ。基準と完全に同じ損益の候補は差がゼロで分母もゼロになる。微小な定数を足して通す前に、重複候補の識別と退化系列の処理を固定する。ほぼゼロの分散なら、誤った時刻整列や丸めも点検する。
stationary bootstrapは全候補で同じ索引を共有する
再標本化する基本単位は、ある日の全候補の差を並べた一行である。最初の索引を一様に選び、次は再開始確率qで新しい索引を選ぶ。それ以外は一つ先へ進み、末尾の次は先頭へ循環する。連続部分の長さは幾何分布で期待長は1/q。長さを固定するブロック方式とは異なる。この索引列Ib,1…Ib,nを反復bごとに作り、全候補へそのまま適用する。
たとえば急落日に順張り群がそろって利益を出し、逆張り群がそろって損失を出した関係も、同じ行を抽出すれば残る。候補ごとに索引を別々に作ると、実際には同時に起きなかった損益の組合せが生まれ、最大値の分布を別物にしてしまう。基準も別の日から引かず、既に計算した差の行を抽出する方が時刻対応を監査しやすい。
無取引日は欠損ではない。資本を置いて待機した日のリターンとして、基準と同じカレンダーに残す。一方、価格欠落を都合よくゼロ埋めしてはいけない。候補ごとに異なる有効日だけを使うと、共通のnと共同分布が定まらないため、共通評価期間や除外日の規則を先に決める。保有期間が重なる取引を一件ずつ独立抽出する方法へ、途中で置き換えることも避ける。
consistent SPAの再中心化を符号から確認する
consistent版で使う平均の推定値は、μ̂ck=d̄k×1{√n d̄k/σ̂k ≤ −√(2 log log n)}である。1{条件}は、条件を満たせば1、それ以外なら0。logは自然対数とする。十分に負の標準化平均を持つ候補には負の平均を残し、それ以外はゼロに置く。境界付近の候補を、単に平均が負だったという理由だけで無関係と決めない仕組みだ。
各反復の統計量はT*SPA,b=max(0, maxk√n[d̄*k,b−d̄k+μ̂ck]/σ̂k)。元の平均を引いて抽出誤差を作り、帰無仮説に沿う中心を足す。明確に劣る候補ではμ̂が負なので下へ戻り、競争への寄与が抑えられる。負の中心を「さらに引く」と逆に上へ持ち上げてしまうため、符号を小さな人工配列で確認する。
この式では元標本のσ̂とμ̂を反復間で固定する。分母を各反復で再推定する別実装を混ぜるなら、同じ検定だと見なさず、その理論と仕様を確認する。consistentという語は有限標本で必ず正答する意味ではない。閾値で境界候補と明確な劣悪候補を漸近的に区別する設計を指す。標準化だけの効果と再中心化の効果を診断用に分離すれば、RCとの差を説明しやすい。
仮想の指数先物研究を、実行順へ落とす
仮に日次1,000観測で、指数先物の順張り60設定、逆張り60設定、時間帯フィルター80設定を比較したとする。主基準は現在運用中の単純な順張りで、候補も基準も同じ資本、事前固定のリスク目標と費用モデルを使う。有望な設定が一つある一方、高回転で費用負けする設定が多数ある。この状況では、平均差が高い一本だけを取り出すと探索の影響を無視し、劣悪候補を全て同点に置くと検出力を失いうる。
まず200列の差系列を固定し、候補ID、生成規則、共通日付、費用前後の平均差、長期標準偏差を保存する。次に同じ再標本索引でRCとconsistent SPAを計算する。例として期待ブロック長5、10、20日を事前の感度設定にしてもよいが、これは最適値ではない。差の自己相関、保有期間、変動の連続性を見て設定理由を書き、最も小さいp値の長さだけを採用しない。
p値は観測統計量以上の再標本統計量の割合として評価する。有限回の反復では推定誤差があるので、反復数、乱数シード、同値の扱いを記録する。判定線に近ければ、事前に定めた規則で反復を増やして精度を確認する。観測SPA統計量がゼロなら、全候補が標本上も基準を超えていないため、棄却しない扱いにする。本例では実データも計算もないので、p値や合格候補を数字で作ることはしない。
研究ノートを監査できる形にする
検定前の監査では、候補の差系列を数日だけ手計算するとよい。建玉が変わらない日、往復売買した日、ロールした日を一つずつ選び、手数料の二重計上や証拠金を分母にした過大な利回りがないか確かめる。現行戦略と候補の取引時刻が違うなら、終値の値洗いに統一しても、発注時に使えた情報の範囲は別に点検する。同じ価格表を使ったことだけでは公平な比較にならない。
次に再標本器へ人工データを渡す。二つの候補の差が完全に同じなら、全反復でも両列の平均は一致するはずだ。片方がもう片方の符号反転なら、その関係も各反復で保存される。保存されなければ、索引の共有か行列の向きを誤っている。明確に負の定数へ小さな変動を加えた候補も用意し、再中心化後の平均が正へ動かないことを確かめる。これらは市場での優位性を調べる実験ではなく、実装の不変条件を調べる単体テストである。
保存物は最終的な検定値だけにしない。候補一覧の版、差行列の日付範囲、欠損処理、分散推定法、平均ブロック長、反復数、再中心化された候補の一覧を一組にする。費用モデルを変えたら差行列から作り直す。費用の変更は平均だけでなく変動や系列相関も変えるため、以前の分母や帰無分布をそのまま流用するのは不適切だ。再検証の理由が新しい約定資料なのか、不合格を見た後の調整なのかも区別して記録する。
検定の実装比較で値が違ったら、最初に損失差の正負、ゼロでの切断、再中心化の方式を照合する。その後に分散の尺度、共通索引、循環境界、同値の数え方を確認する。計算速度を上げるために候補ごとに別乱数へ変えたり、長いブロックを固定長へ置き換えたりすると、処理時間だけでなく推定対象も変わる。最適化前の小さな参照実装と一致することを、速度より先に合格条件にしておく。
再現担当者が候補名を知らなくても同じ判定を得られるかを確認する。採用したい戦略だけ例外扱いする余地が残っていれば、検定前の仕様へ戻って修正する。
検定後に残すべき研究判断
RCは棄却せずSPAだけが棄却した場合、直ちに都合の良い方を採らない。どの候補が再中心化の対象になったか、最大の生の平均差と最大の標準化平均を担う候補は同じか、分散推定やブロック長に結果が依存していないかを追う。SPAが常にRCより小さいp値になるという一般則はなく、標準化によって順位も変わる。劣悪候補の影響を抑えることと、候補間の比較尺度を変えることは別の操作である。
全体の棄却が示すのは、指定した集合に基準を上回る候補が少なくとも一つあるという証拠であり、画面上の一位が個別に有意だという認定ではない。採用する一本の特定には追加の選択手順や未使用期間での確認が要る。探索台帳が途中からしか残っていないなら、検定の対象もその記録済み集合に限定される。検定を追加しても、消えた試行履歴は復元されない。
また、再標本化は過去の差系列を組み替えるので、売買規則の未来参照や約定不能を修正してくれない。相場構造の断絶が強い期間や、学習窓を拡張し続ける再帰推定へ、定常性を前提としたSPAを無条件に適用しない。運用メモには「何に、どの費用と資本条件で勝つ問いか」「どの探索集合を補正したか」「どの依存仮定で確かめたか」を残す。この三点が明確なら、p値を採否の一票として扱いながら、次の検証で何を変えるべきかまで判断できる。
コメント