雇用や景気の数字を使った売買ルールを検証したところ、発表直後の方向を驚くほどよく当てられた。しかし使ったデータが、当時の発表値ではなく数カ月後に改定された数字なら、その成績には未来の情報が混ざっている可能性がある。
経済指標は、一度公表した数字が永久に固定されるとは限らない。追加回答、季節調整、年次の基準改定などで過去の値も変わる。現在ダウンロードできる整った時系列は、過去のトレーダーが見ていた画面と同じではない。本稿ではデータの「対象時点」と「知ることができた時点」を分け、先読みを防ぐ方法を説明する。

一つの数字には少なくとも二つの時間がある
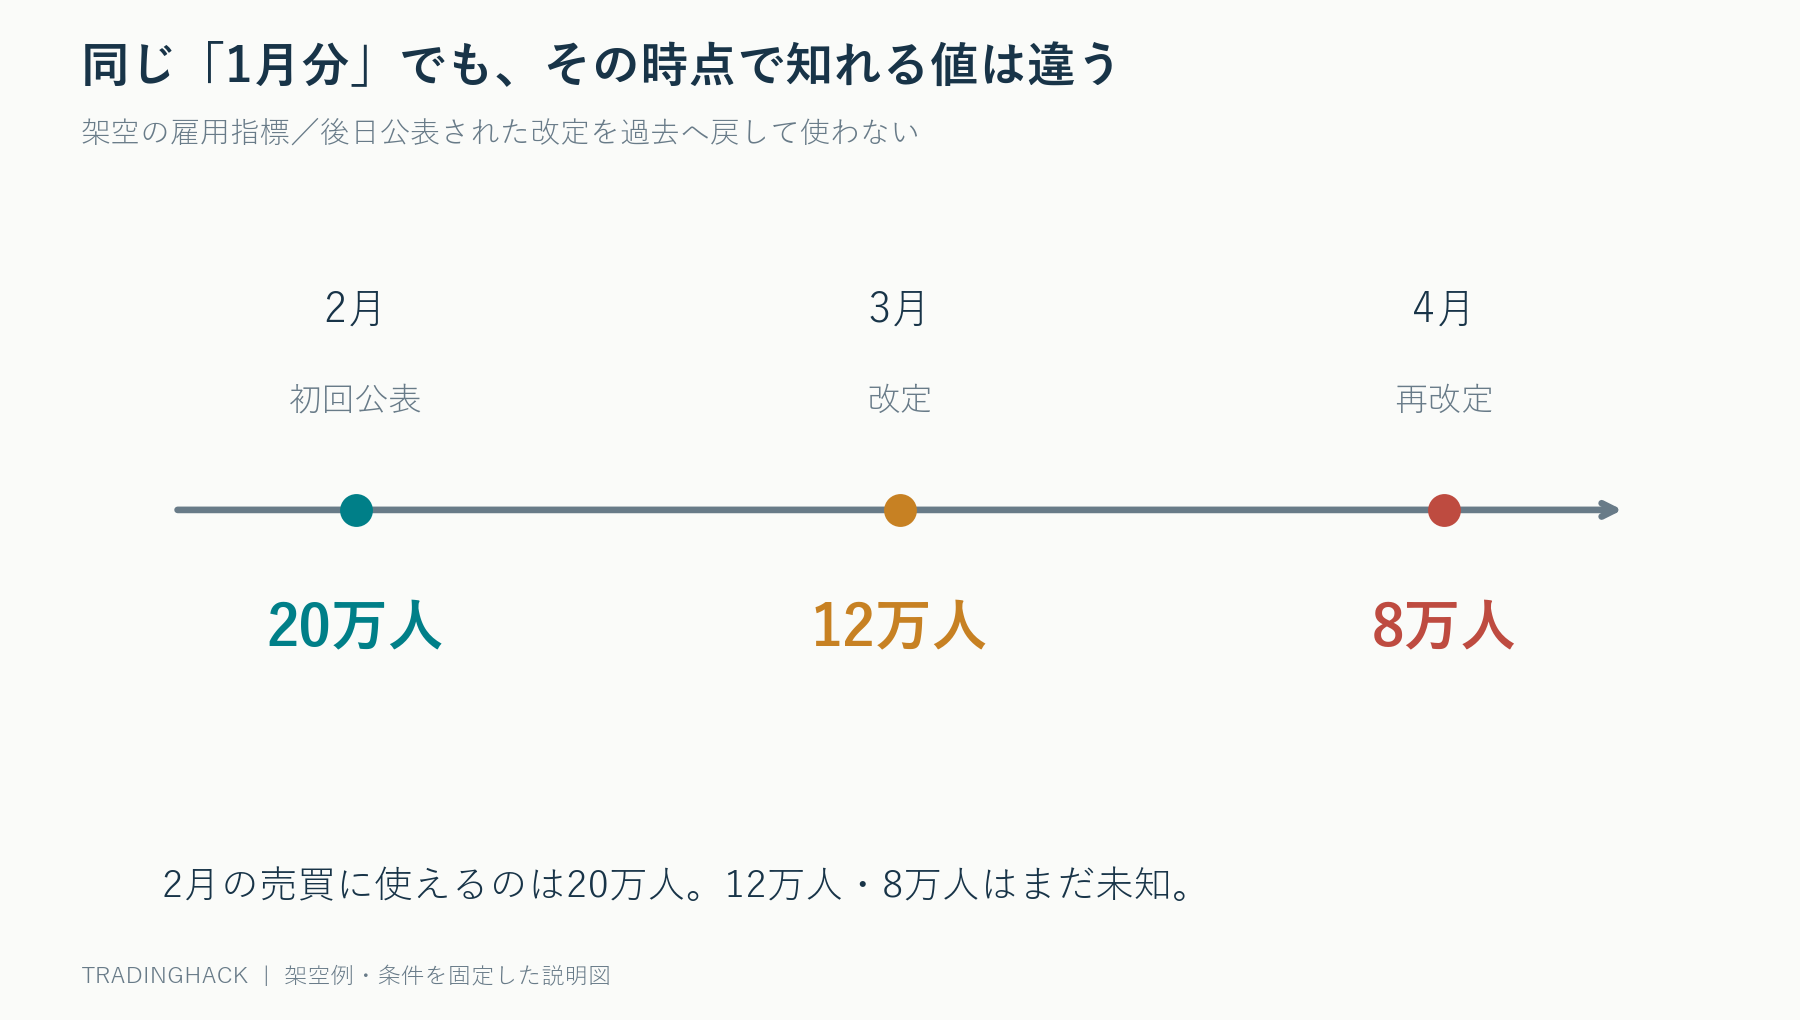
「1月の雇用」という表示は、数字が対象としている月を示す。1月中にその値が分かったという意味ではない。仮に初回公表が2月、最初の改定が3月、次の改定が4月なら、同じ1月の欄に時間とともに異なる数字が入る。
必要なのは、対象月、公表日時、改定時点、データを実際に受信した日時である。取引時刻より後に分かった値を入力へ使えば先読みになる。月次の表の行名が1月だからといって、1月初日にその数字を配置してよいわけではない。
初回20万人、後日8万人なら売買判断が反転する
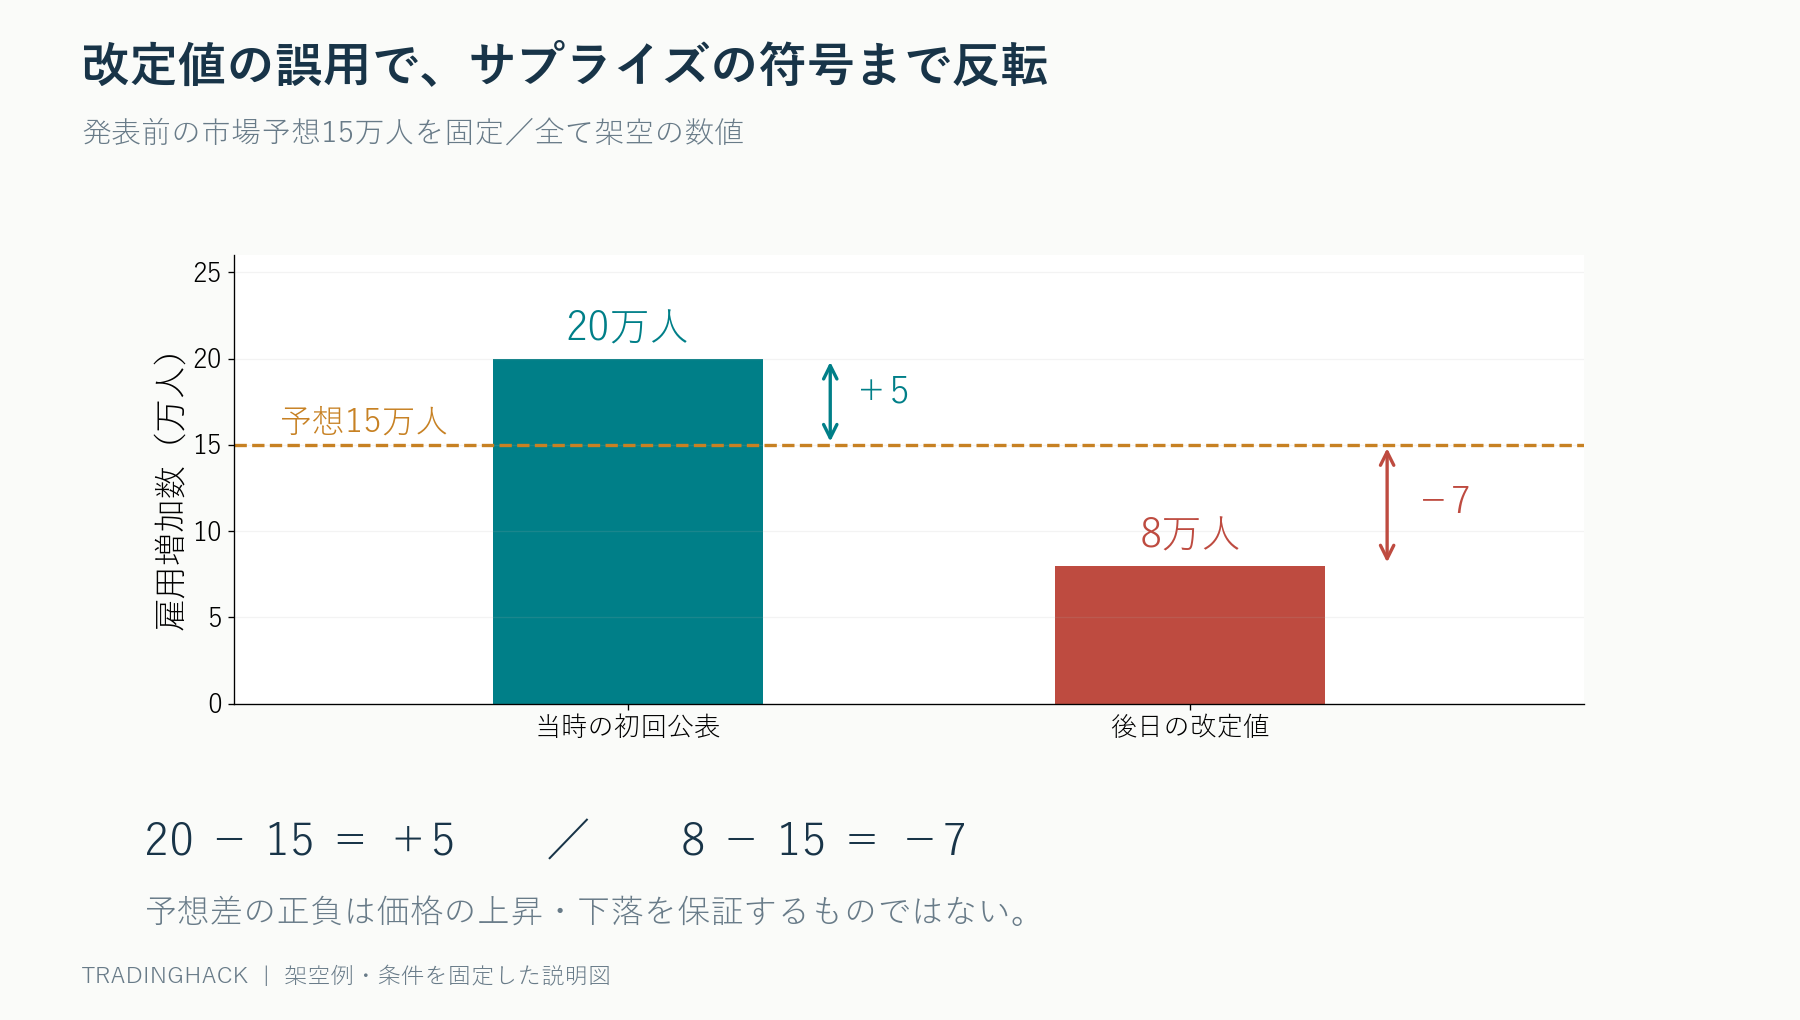
架空の雇用指標で、1月分が2月の初回発表では20万人増、3月に12万人増、4月に8万人増へ改定されたとする。2月の発表直前の市場予想を15万人増と仮定すれば、その場で計算できた予想差は20−15=プラス5万人だ。
現在のデータベースにある8万人を使うと、8−15=マイナス7万人となる。同じ過去のイベントなのに、予想を上回ったか下回ったかまで逆転する。改定後の値で当時の為替や金利の反応を説明すると、実際には不可能だった情報を利用してしまう。
これは実際の雇用統計の数値ではなく、先読みを可視化する例である。また予想を上回れば必ず通貨や株価が上がるという意味でもない。同時に出る賃金、失業率、過去分の改定、事前のポジションによって市場の反応は異なる。まず予想差自体を当時の情報で計算することが出発点だ。
ヴィンテージとは「その時点の版」
経済データのヴィンテージは、ある時点で利用可能だったデータの版を指す。同じ系列でも、2月時点の版と4月時点の版を分けて保存すれば、過去の情報集合を復元しやすくなる。最新値だけを上書き保存する方式では、この違いが失われる。
セントルイス連銀のALFREDは、経済データの過去の版を扱う仕組みを提供している。FRED APIにもリアルタイム期間やヴィンテージ日付を指定する機能がある。「対象期間を昔にする」ことと「当時の版を選ぶ」ことは別の操作である。
例えば対象月を10年前にしても、版の指定が最新のままなら、10年前の対象月について現在分かっている値が返る場合がある。APIのパラメータ名だけで判断せず、取得した版の日付と、実際に値が改定されたケースを突き合わせて動作を確認する。
予想差の検証には市場予想の版も必要
公表値を正しく保存しても、市場予想が後から差し替えられていれば検証は崩れる。予想の集計対象、締切時刻、中央値か平均値か、提供元を残す必要がある。発表後のウェブページに載った「予想」が、そのまま発表直前に見えていた値だったとは限らない。
予想差を標準化する場合も注意する。過去の予想差の標準偏差で割るなら、取引時点までのデータだけから計算する。全期間の平均や標準偏差を使うと、将来の大きなショックによって昔のシグナルの尺度が変わってしまう。
初回値を固定する方式と、当時の最新値を使う方式
初回発表のサプライズを取引するなら、各対象月の初回値を固定して並べる方式が分かりやすい。一方、「現在分かっている過去6カ月の景気変化」を使うルールなら、各売買時点で既に公表済みの改定を反映した履歴が必要になる。
この二つは正解と不正解の関係ではなく、異なる情報を使う戦略である。改定を知った後でも初回値を使い続ける設計は可能だが、そう決めたルールとして検証する。過去の改定を取り込む戦略なのに、全ての月を初回値へ固定すると実運用と一致しない。
例えば3月の判断で1月分が12万人へ改定済みなら、その12万人は利用できる。しかし4月に初めて分かる8万人はまだ使えない。「改定値は全て禁止」ではなく、判断時点までに公開されていた版だけを使うことが原則になる。
最新の一行だけ直しても移動平均には先読みが残る
景気指標の6カ月移動平均を使う場合、直近月だけを初回値へ戻しても、残る5カ月が将来の改定値なら不十分だ。その売買時点で知られていた過去6カ月全体を復元し、その版から平均を計算する必要がある。
これは景気局面の分類や機械学習の特徴量でも同じだ。最新の長期系列で「当時は不況だった」とラベルを付け、そのラベルを過去の売買判断へ与えると、後から確定した景気認識を先に知っていたことになる。事後分析の説明変数と、リアルタイムで使える入力を区別する。
日付単位の版では発表直後の秒単位売買を再現できない
ALFREDのヘルプでは、データの追加は通常一営業日以内に行われることや、資料によっては公表日ではなくFREDで初めて利用可能になった日が用いられる場合が説明されている。日付単位の履歴は有用だが、当日の何時何分何秒に自分のシステムが受信できたかまで保証するものではない。
発表数秒後の売買を検証するなら、公表機関のアーカイブ、正確な公開時刻、配信サービスの受信記録、注文送信の遅延が必要になる。日次のヴィンテージがあるだけで、発表瞬間に同じ情報へアクセスできたと仮定しない。
一方、翌営業日に判定する低頻度戦略なら、時刻の問題をより保守的に扱いやすい。利用可能日を明示し、取得・確認後の売買可能時点からシグナルを有効にする。遅らせたことで戦略の性質は変わるが、見えない配信速度を理想化するより仕様が明確になる。
公表前の空欄を後の値で埋めない
月次データを日次価格へ結合するとき、対象月の最初の日から値を入れると、発表前から情報を持っていた形になる。例えば1月分が2月に公表されたなら、その公表可能時点までは一つ前に利用できた情報を維持するか、未公表として扱う。
後の値を過去へ埋め戻すバックフィルは、とくに危険だ。公表後の値を次の公表まで持ち越すフォワードフィルも、開始地点が正しいことが条件になる。行の日付ではなく情報の利用可能日時をキーに結合し、取引時刻以前に利用できた最新の記録だけを選ぶ。
実務では「変更されない生データ」と「計算結果」を分ける
取得した公表資料やAPI応答は、取得日時と出典を付けて版ごとに残す。別の表で対象期間、公表日時、版の日付、数値、単位、季節調整の有無を管理する。その上に、予想差や移動平均などの計算結果を作れば、数値が変わったときに理由を追跡できる。
万人と千人、前月比と前年比、年率換算と非年率を混同するだけでも、もっともらしい売買シグナルができてしまう。丸めた見出し数値と詳細表の値が違うケースもあるため、どの値を入力へ使ったかを固定する。異なる系列を途中でつなぐ場合は定義変更も記録する。
機械学習では教師データの成熟時点も見る
将来確定する値を、予測したい正解として使うこと自体はあり得る。例えば将来の最終推計値を予測対象にする設計だ。ただし、ある過去時点でモデルを訓練するなら、その時点でまだ確定していなかった正解を訓練へ入れてはいけない。
入力に未来を混ぜないだけでなく、教師データがいつ観測可能になったかも管理する。モデル更新日時までに正解が判明した標本だけで学習し、その後の未使用期間へ進める。単純に対象月で訓練と検証を区切るだけでは、後日改定による情報漏れを防げない場合がある。
一件のシグナルから出典まで逆にたどれるか
検証結果から任意の売買を一件選び、入力値、使用した版、公表資料、利用可能時刻へ逆にたどってみる。例えば「2月の発表後に買った」という記録なら、20万人という初回値と15万人という事前予想を、当時の資料で説明できるか確認する。最終値8万人しか残っていなければ、その取引は再現性に欠ける。
出典が見つからない値を、近い日の数字で推測して埋めると検証の精度を装うことになる。不明な値は不明とし、対象取引を除外した結果と含めた参考結果を分ける。除外が特定の時期に偏るなら、その偏りも報告する必要がある。荒れたイベントだけ記録が欠けていれば、残った取引だけの成績は楽観的になり得る。
この監査を数件行うだけでも、対象月と公表日の取り違え、単位の混在、更新済みページの誤用を発見できる。全履歴の処理を高速化する前に、少数のイベントを手作業で再現することが、誤った大規模検証を避ける近道になる。
三通りの検証を並べて差の理由を調べる
同じ注文条件と費用で、最新改定値を使った参考結果、初回値を固定した結果、各時点の公表済み履歴を使った結果を比較する。最初の結果は実行可能な成績ではなく、改定がどれだけ影響するかを見る診断用と位置付ける。
差が大きければ、売買方向が変わったイベント、注文時刻がずれたイベント、シグナルの大きさだけ変わったイベントに分ける。利益が消えたからといって指標が無意味とは限らない。元の成績が、当時手に入らなかった情報に依存していたかを確認する作業である。
改定は統計精度を高める通常の過程でもあり、それだけで操作や不正を意味しない。トレーダーの課題は改定を否定することではなく、「その時点で何を知ることができたか」を再現することだ。きれいに完成した時系列より、当時の不完全な情報を正しく残した履歴の方が、実運用の検証には価値がある。
参考:FRED APIのリアルタイム期間、ヴィンテージ日付の取得仕様、ALFRED公式ヘルプ。数値例は実際の統計発表とは異なる架空の設定。
コメント