トリプルバリアで作ったラベルをCPCVへ渡すとき、検証日と同じ日付の学習行だけを消しても情報漏洩は止まりません。月曜に始まったイベントが木曜の利確で終了するなら、そのラベルは月曜から木曜までの価格に依存します。火曜を検証へ置いた場合、月曜の行は学習から除外すべきです。必要なのは固定本数の空白ではなく、イベントごとの情報区間を比較する実装です。
ここでは、利確・損切り・時間切れという三つの終了条件を持つラベルを対象に、区間の保存仕様、重複判定、embargo、単体テストまで設計します。説明用の時刻と件数は架空です。分類器の成績を上げる工夫ではなく、評価に混ざってはいけない価格情報を追跡するための手順として読んでください。

開始時刻と終了時刻を、ラベル値と同じ重要度で保存する
イベント表にはevent_id、銘柄、予測時刻、約定可能時刻、最初の価格参照時刻、ラベル確定時刻、終了理由を持たせます。特徴量が確定する時刻と売買が始まる時刻は一致するとは限りません。終値でシグナルを作り翌営業日寄りで取引する設計なら、終値と翌朝の間に存在する情報を予測へ逆流させないよう、二つの時刻を分離します。
ラベル区間の右端は、原則として実際に最初に触れたバリアの時刻です。最大保有期限を全イベントの終了時刻へ代用すると漏洩に対して保守的にはなりますが、早期終了した学習イベントまで余分に捨てます。逆に、利確したはずだから翌日の始値で終了したことにする、といった事後的な短縮は危険です。ラベルを決めるために最後に参照した価格まで含めます。
原典はLópez de Pradoの『Advances in Financial Machine Learning』です。ラベリングは第3章、金融時系列の交差検証は第7章、CPCVは第12章に対応します。CPCVの直接の出典は論文ではなくこの専門書であり、以下の端点規約と監査用コードは本記事の実装設計です。
閉区間で統一すれば、接触する端点も判定できる
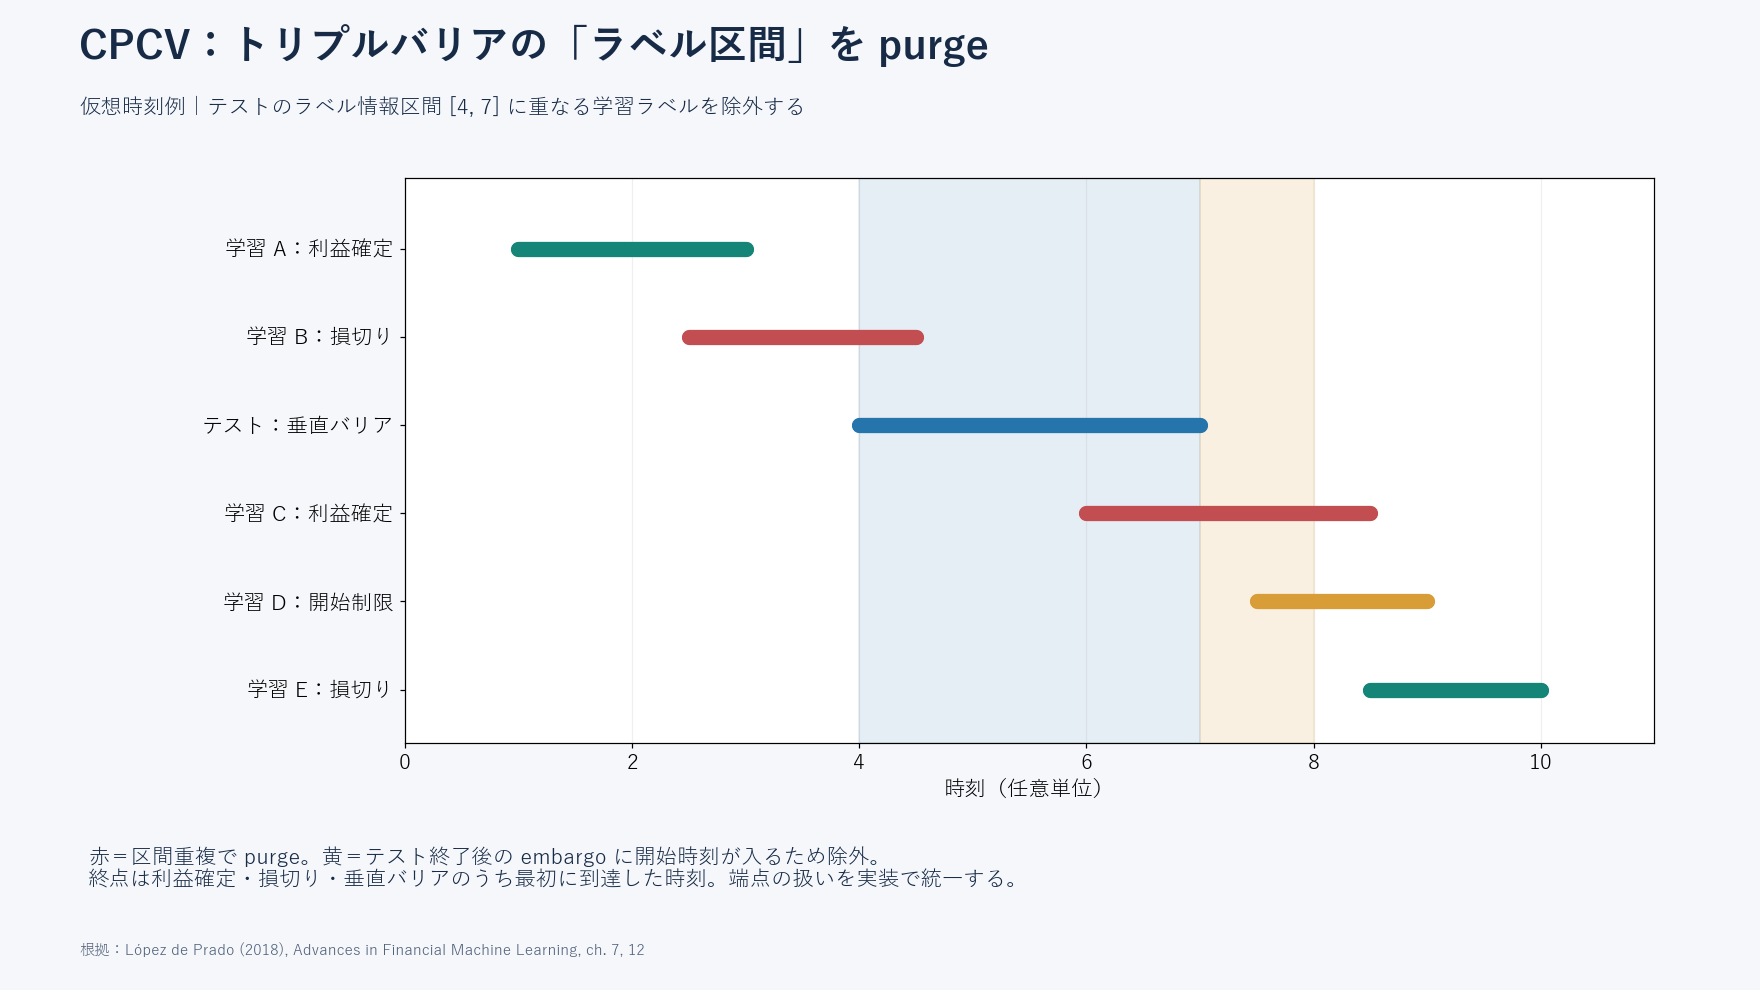
本例ではイベントiの情報区間を閉区間I_i=[s_i,e_i]と定義します。学習イベントiと検証イベントjが重なる条件は、s_i ≤ e_j、かつs_j ≤ e_iです。片方がもう片方を丸ごと包む場合も含められるため、「学習開始が検証期間の中にあるか」だけを見る判定とは違います。終了と開始が同じ時刻の場合も重複とします。
def overlaps(s_i, e_i, s_j, e_j):
    return s_i <= e_j and s_j <= e_i

def purge(train_ids, test_ids, starts, ends):
    kept = []
    for i in train_ids:
        hit = any(overlaps(starts[i], ends[i], starts[j], ends[j])
                  for j in test_ids)
        if not hit:
            kept.append(i)
    return kept
これは判定を確認するための素朴な実装で、学習件数と検証件数の積に比例して計算が増えます。本番では検証区間を開始時刻順に並べ、重なった区間だけを併合して探索できます。ただし離れた検証区間を最初の開始から最後の終了まで一つにまとめると、間の安全な学習イベントも失います。高速化前後で残存IDが完全一致することをテストします。
10時の検証イベントで、五つの境界ケースを試す
検証イベントを10時00分〜10時05分とします。学習Aが9時58分〜10時01分なら左側から重なるため除外。Bが9時55分〜10時10分なら検証を内包するため除外。Cが10時02分〜10時03分なら検証内に収まるため除外です。Dが9時50分〜9時59分なら残し、Eが10時05分〜10時08分なら端点を共有するため除外します。
ゼロ長区間もテストします。10時03分に開始・終了するイベントは閉区間では一点を参照するため、上記の検証と重なります。半開区間へ変えること自体は可能ですが、その場合は価格リターンがどのバーへ帰属するかまで仕様を変える必要があります。比較演算子だけを変更して件数を増やしてはいけません。
加えて、e_iがs_iより前、終了時刻が欠損、タイムゾーンが混在、夏時間の時刻が曖昧、という入力は分割前にエラーにします。期間末で未決着のラベルを都合よく時間切れとして確定すると、通常イベントと観測条件が異なります。十分な将来価格がないイベントは、あらかじめ定めた未確定処理へ送ります。
トリプルバリア固有の「実際には見ていない価格」問題
日足の高値が利確、安値が損切りの両方へ触れる日には、日足だけで先着順を決められません。ここで常に利確を先にするとラベルも損益も楽観化します。より細かいデータを使う、曖昧イベントを別扱いする、保守的な約定規約を固定する、といった処理が必要です。purgeはこの順序不明問題を修復しません。
価格がバリアを飛び越えた場合も、バリア価格で必ず約定したという損益へ置き換えないようにします。ラベルは上側へ触れたという分類でも、損益は次の取引可能価格で計算することがあります。区間終端にはラベル判定時刻を残し、執行評価には別の決済時刻を使うと、二つの目的を混同せず監査できます。
embargoはpurgeの代用ではない
purgeが既知のラベル重複を除くのに対し、embargoは検証の直後にある学習候補へ追加の待機帯を置きます。本例では、併合済み検証区間の右端eから営業時間でΔだけ進めた時刻まで、開始時刻が(e,e+Δ]に入る学習イベントを除外します。休日を含む暦時間なのか、市場が開いている時間なのかを必ず書き分けます。
たとえば終値直前の検証に対して30分のembargoを設けるとき、暦時間で進めれば夜間に終わり、翌朝の学習行が残ります。営業時間で進めれば翌セッションへ持ち越します。どちらが正しいかはラベルと特徴量の依存関係次第です。Δを利益が最大になるまで調整せず、想定する持越しと情報の減衰から決めます。
複数の非連続な検証群を選ぶCPCVでは、それぞれの検証区間群に待機帯が必要です。最後の検証群の後だけembargoを入れる実装は、途中の群の直後を見逃します。また、データ末尾の待機帯を先頭へ循環させる処理はしません。再標本化とは違い、実在時系列の検証分割には循環するカレンダーがないからです。
特徴量の参照範囲は、ラベル区間とは別に点検する
ラベルの重複を消しても、全期間で標準化や特徴量選択を済ませれば検証情報が学習へ入ります。標準化器、欠損補完器、主成分、特徴選択器は各分割の学習側だけでfitします。検証側にはその変換を適用するだけです。利確幅を決めるボラティリティも、イベント開始前に利用可能な価格から推定します。
過去60分のローリング特徴量を使うなら、検証終了後の学習イベントがその60分の中へ検証価格を含むことがあります。これはラベル区間だけの判定では拾えません。特徴量の依存開始f_iも保存し、必要に応じて[f_i,e_i]を使った厳格な情報分離を追加します。共有された過去価格を許す通常の予測評価と、完全な情報分離では目的が異なるので、採用した規約を明記します。
同時刻に複数銘柄を扱う場合、イベント行を無作為に分けると市場共通のショックが学習と検証へまたがります。時間ブロックへの所属は予測時刻で決め、原則として同じ日時の横断面を一緒に移します。一方、区間交差を銘柄内だけで判定するか全銘柄で判定するかは、指数特徴量や横断面ラベルの共有構造から選びます。
CPCVの組合せを増やす前に、残存標本を数える
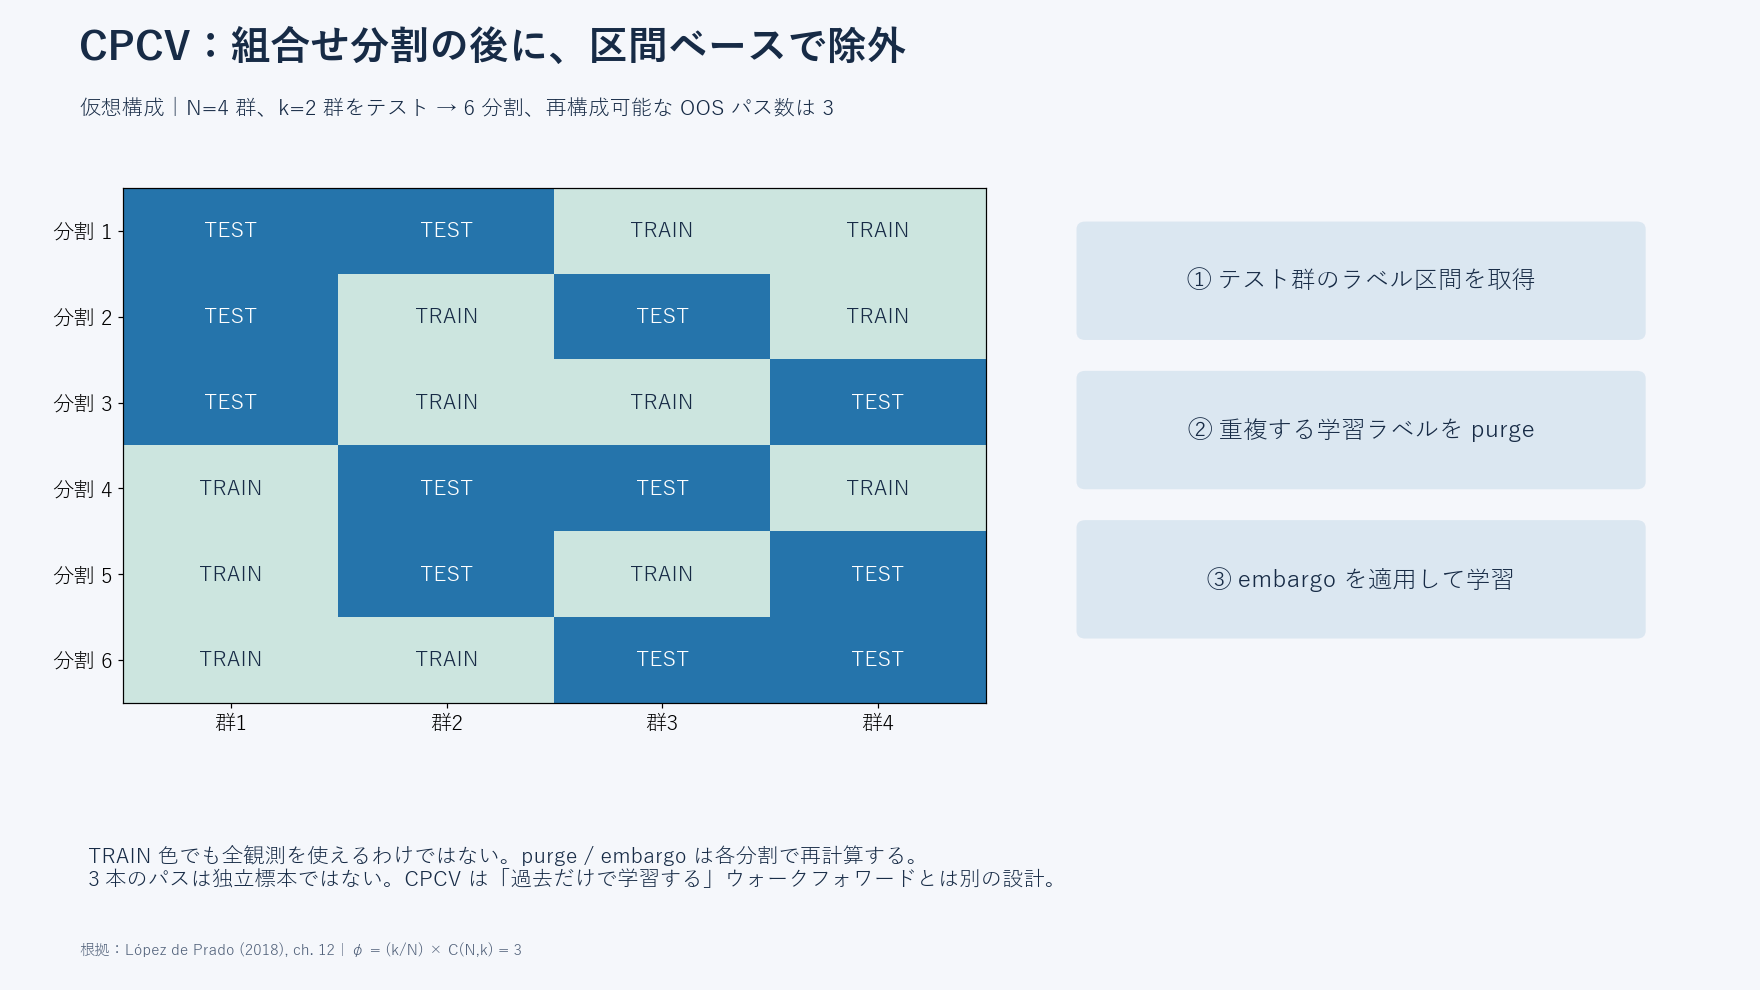
時間順に6群を作り2群を検証へ選ぶなら、組合せは15です。purgeとembargoを適用する前の学習比率は4/6ですが、除外後も同じとは限りません。長い未決着イベントが集中する時期では学習数が大きく減ります。各分割で除外理由別件数、実効学習期間、各クラス件数、最長ラベル期間を保存します。
学習側の一方のクラスがゼロになった分割を、成績が出ないから削除すると評価は歪みます。分割設計の実行可能性を成績計算より前に判定し、不適格分割がある場合の扱いを固定します。群を粗くする変更も研究設計の変更として再実行します。15分割は15個の独立した歴史ではなく、同じデータを共有する比較です。
CPCVでは検証時点より後の時期を学習へ使う分割もあります。区間漏洩を防いだからといって、未来から過去への学習が時系列本番運用と同じになるわけではありません。レジームの組合せに対する頑健性を調べる評価と、過去だけで逐次更新するwalk-forward評価を区別し、後者でも運用手順を別途検証します。
終了時刻を一つ動かす回帰テストを作る
説明用に100件の学習イベントと20件の検証イベントを用意し、まずラベル区間だけで12件が除外されたとします。特徴量依存による追加除外が7件、embargoによる追加除外が3件なら残存は78件です。同じIDが二つの理由へ該当する場合もあるので、理由別件数をそのまま足すのではなく、除外IDの和集合で残存数を計算します。理由フラグは複数立てたまま残せます。
次に検証イベント一件の終了を10時05分から10時07分へ延ばし、残存IDの差分を確認します。新たに重なる10時06分開始の学習行が消える一方、遠く離れた9時台の行が変わるなら実装に疑いがあります。ただし区間併合によって検証群が連結した場合や、右端に連動してembargoが移動した場合は、その影響も差分理由として説明できる必要があります。
実データでは決済価格の訂正で終了時刻が変わることもあります。ラベル表を上書きするだけでは、以前の分割結果とモデルを再現できません。価格データ版、ラベル生成コード版、区間規約版、分割IDをひも付け、終了時刻の変更で影響を受ける分割を再計算します。予測値のキャッシュには学習ID集合のハッシュも含め、古い学習集合の結果を誤って再利用しないようにします。
また、学習側のサンプル重みをイベントの同時発生数から作る場合は、その計算母集団を明示します。検証ラベルの将来終了時刻を使って学習重みを最適化すると、除外判定を正しくしても別経路で検証情報を使うことになります。学習集合内で重みを再生成する設計と、予測時点で既知の保有情報だけを使う設計を区別して記録します。
完了判定はSharpeではなく、不変条件で行う
まず全分割で、残った学習イベントと検証イベントに禁止した区間交差がないことを自動確認します。次に、分割順を入れ替えても除外IDが変わらないこと、単一検証イベントの集合と併合区間の判定が一致することを確かめます。最後に、前処理のfitへ渡ったIDが残存学習IDの部分集合であることをログから検査します。
この監査が通った後に初めて予測と損益を評価します。トリプルバリアの終了時刻、端点接触、非連続検証群、営業時間のembargoを明示すれば、CPCVは「使っているから安全」という名称ではなく、何を除外したか説明できる検証になります。もっとも高いスコアより、同じ入力から同じ除外判断を再現できることが実装の合格条件です。
コメント