探索窓を20日から21日へ動かした二つの戦略は、二回の試行ですが、独立した二回の発見機会とは限りません。一方、「よく似ているから一回」と数えれば、100設定の中から一番よかった結果を選んだ事実が消えます。Deflated Sharpe Ratio(DSR)を監査可能にするには、まず試行台帳を作り、何を試し、どの損益系列が相関し、どの推定を使って実効試行数を決めたのか説明する必要があります。
この記事の主題はDSRの数値を高くすることではありません。試行数の仮定を変えても採否が維持されるか、没案や人手の判断が入力から消えていないかを調べる研究会計です。数値はすべて説明用であり、実在する運用成績ではありません。

台帳の一行は「選ばれた設定」ではなく「評価した試行」
trial_id、parent_id、研究開始時刻、仮説、コード版、データ版、対象市場、観測期間、パラメータ、特徴量、費用モデル、選択指標を記録します。日次費用後リターンは別ファイルへ保存し、そのハッシュを台帳へ持たせます。探索プログラムの出力だけでなく、チャートを見て閾値を変えた判断や、不採用の時間足も選択へ影響したなら履歴に残します。
同じコードを同じデータで再実行しただけなら、乱数と出力を確認して再現試行と区別できます。設定が同じでも、データ期間を変えてよい期間を探したなら新しい選択機会です。取引コストを修正した場合も、単なる入力訂正か、利益が残る費用仮定を選んだのかを分類します。評価対象を後から狭めた判断を台帳外へ追い出さないことが重要です。
根拠となる一次論文はBailey・López de Prado(2014)のThe Deflated Sharpe Ratio: Correcting for Selection Bias, Backtest Overfitting, and Non-Normalityです。試行間のSharpeのばらつきと独立試行数に加え、採用候補の標本長・歪度・尖度を使います。相関する試行の扱いは付録A.3に議論があり、実効数が入力上の重要な不確実性であることが読み取れます。
相関行列を作る前に、比較する口座を揃える
候補ごとのリターンは同じ日時、同じ資金単位、同じ現金利息規約で整列させます。取引がなかった日は原則として現金保有の収益を入れますが、価格取得障害による欠損をゼロへ置き換えてはいけません。長短戦略の符号を取り違えたり、費用前と費用後を混ぜたりすると、相関は数値として計算できても試行の冗長性を表しません。
候補Aは前半だけ、Bは後半だけという系列へpairwise deletionを使うと、相関係数ごとに観測期間が変わります。その行列は正半定値にならないこともあり、固有値を使う診断を壊します。比較可能な共通期間を明示し、短くなるなら全試行の監査と共通期間上の相関診断を別の成果物として保存します。欠損処理の便利さで研究履歴を削らないようにします。
完全複製がある場合も、件数だけで処理しません。バグによる重複出力は識別して統計入力の二重計上を防げますが、同じパラメータ近傍を何度も見ながら別の条件を選んだ探索行動は残ります。台帳の行数、実際に異なる損益列の数、実効独立数は別の数字として報告します。
固有値参加率1.37は、万能な試行数ではない
図1は4候補のすべての候補間相関が0.8という仮想行列です。固有値は3.4、0.2、0.2、0.2となります。参加率と呼ばれる診断量をN_part=(Σλ)²/Σλ²とすると、16/(11.56+0.12)=約1.37です。主要な線形方向へ変動が集中していることを示し、4本が4つの独立した情報源とは見なしにくいことを可視化します。
ただし、この1.37をそのままDSRの試行数へ代入するのはヒューリスティックです。分散の実効次元と、最大Sharpeが何回の独立探索に相当するかは同じ問題ではありません。共通の市場因子で相関が高くても、まれな独自損失や非線形の選択機会が残ります。図の式はDSR原論文がすべての状況へ推奨した普遍式ではありません。
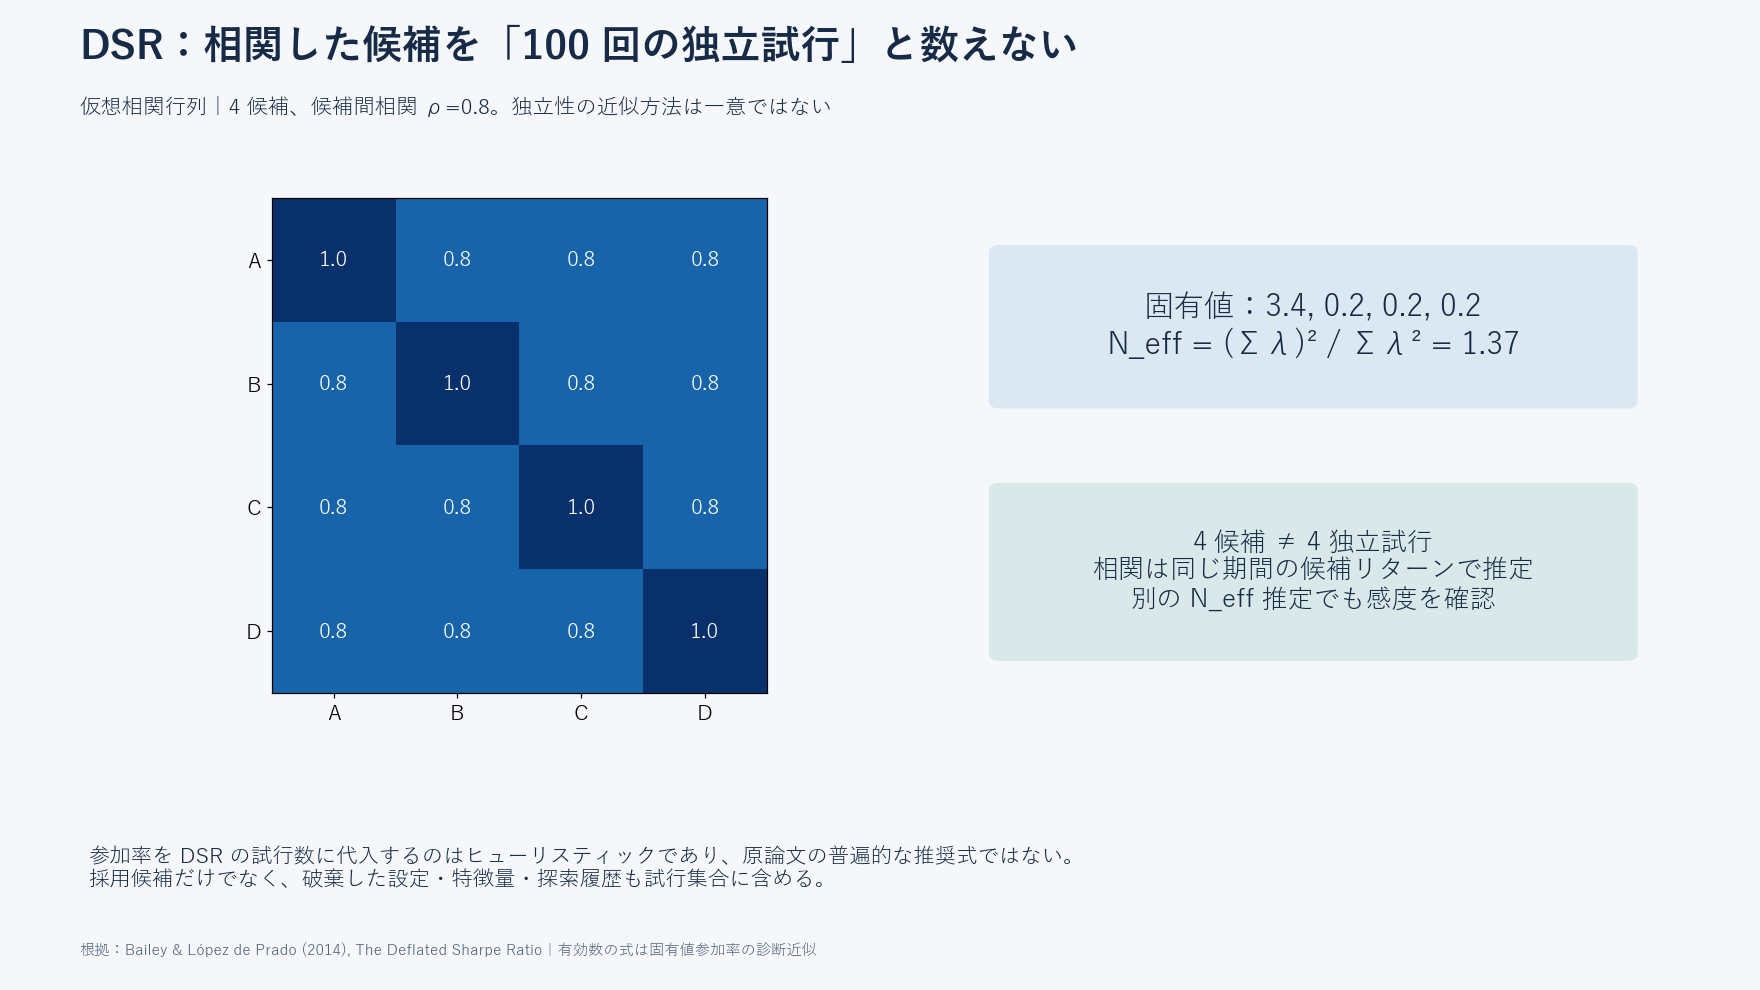
原論文には平均相関から独立数を補間する考え方もありますが、その推定も仮定を持ちます。相関行列をクラスタへ分けた群数、参加率、台帳上の総試行数は一致しないことが普通です。いずれか一つを正解として隠すより、代表的な推定と保守的な総数を並べ、採否の変化を示す方が監査しやすくなります。
実効試行数とSharpe分散をセットで固定する
期待最大Sharpeの基準SR₀を、ゼロ平均の独立正規試行という近似の下で計算する場合、SR₀=σ_SR×{(1−γ)Φ⁻¹(1−1/N)+γΦ⁻¹(1−1/(Ne))}を使います。γは約0.5772、Φは標準正規分布の累積分布です。σ_SRは候補間のSharpe推定値の標準偏差であり、採用戦略の日次リターン標準偏差ではありません。
この違いは重要です。台帳に100候補があっても、入力が採用候補のSharpeと試行数だけならDSRは再計算できません。候補Sharpeの散らばりをどの試行集合から推定したかが必要です。都合のよい候補を除くとσ_SRもNも動くので、補正が強くなるか弱くなるかを件数だけで判断できません。
似た設定を多く保存した結果、候補Sharpe分布が特定の近傍へ偏る場合もあります。全試行を等重みで集計した値と、事前に定義した研究ファミリー別の値を比較し、どの母集団をモデル化しているか書きます。ファミリーを分けた後にその勝者を比較して一つを選んだなら、上位の選択過程も存在します。各群を一回と数えるだけでは十分ではありません。
図2の計算条件をそのまま再現する
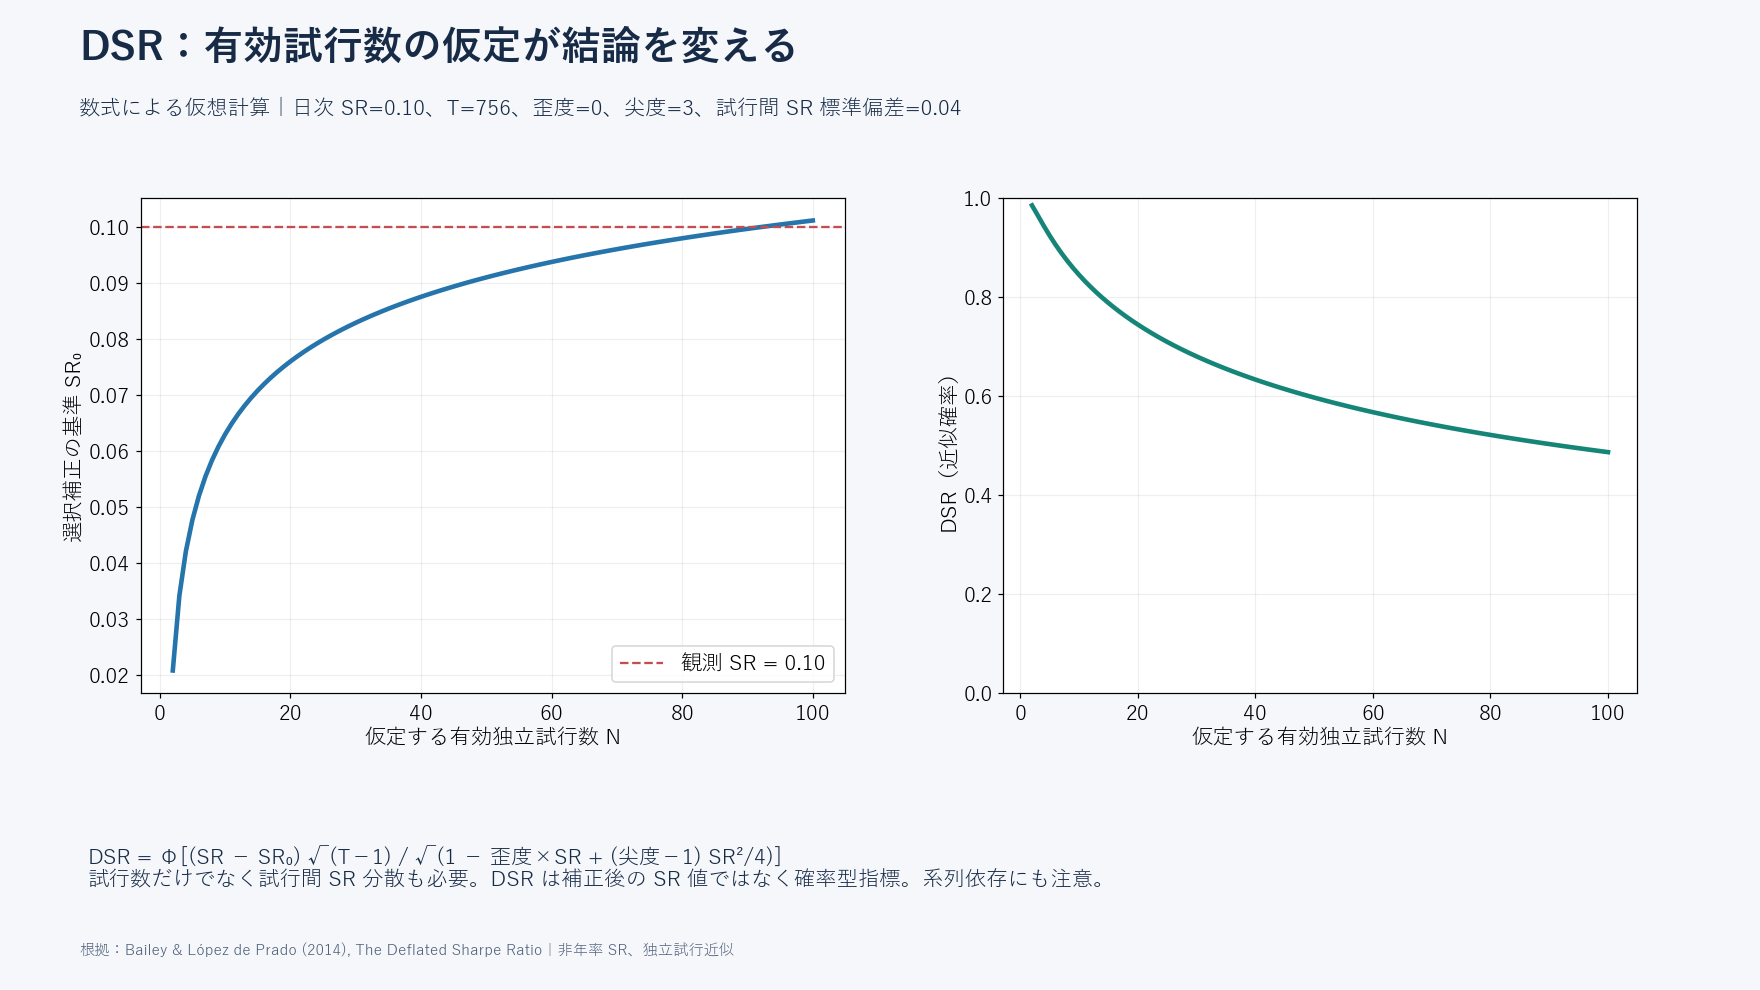
採用候補の日次Sharpeを0.10、観測数Tを756、歪度を0、通常尖度を3、試行間Sharpe標準偏差を0.04に固定します。日次Sharpeは年率値ではありません。独立・同分布近似の下では年率換算で約1.59ですが、DSRの式へは0.10を入れます。Tだけ日次、Sharpeだけ年率という混用は、著しく過大な確信を生みます。
DSR=Φ{(SR−SR₀)√(T−1)/√[1−歪度×SR+(尖度−1)SR²/4]}とします。ここでの尖度3は正規分布の通常尖度であり、超過尖度なら0です。ライブラリが超過尖度を返す場合は3を足してから使用します。値の名前をkurtosisとだけ書かず、どちらの定義か台帳に残します。
同じ入力でNを2、10、100と増やすと、SR₀はおよそ0.0208、0.0630、0.1012へ上がり、DSRはおよそ0.985、0.845、0.487へ下がります。これらは期待最大値の近似式から得た説明値で、小さいNほど近似精度にも注意が必要です。実効数の選び方だけで、同じ日次Sharpeに対する解釈が大きく変わります。
N=1と短い系列は、計算上も別扱いにする
上記の最大値近似へN=1をそのまま渡すと、逆累積分布へ端点が入り発散します。独立した一試行の期待値はゼロ平均モデルならゼロなので、その基準でPSRを計算する別分岐が必要です。参加率が1付近になったからといって近似式へ無条件に代入しません。Nが2未満の領域でどの補間や直接計算を使うかも明示します。
日次損益に自己相関がある場合、756日を756個の独立観測と見なす前提が崩れます。重複保有やポジション平滑化がある戦略では特に問題になります。HACなどでSharpe推定誤差を評価する方法や依存性を保持する再標本化を別途検討しますが、Tだけを恣意的に小さくして原式と同じ検定だと呼ぶのは避けます。
相関は候補間の横方向の依存、自己相関は時間方向の依存です。実効試行数を小さくしたから時間依存まで補正できたわけではありません。研究報告では、候補相関の処理と時系列標準誤差の処理を別々の欄にして、何が未補正かも記載します。
研究台帳が欠けているときに、精密なDSRを出さない
保存された20候補の前に、手元で何百回も設定を試した可能性があるなら、20を完全な試行数として扱えません。探索ログ、ノート、コード履歴から復元し、確認済み件数と不明な探索範囲を分けます。履歴が復元できなければNを複数仮定した感度分析に留め、単一のDSRを正式な合格証として表示しない判断が必要です。
以後の研究は事前に探索予算を決めます。候補生成規則、途中打切りの条件、最終評価日を台帳へ登録し、実行中の失敗もstatus列で保存します。コードが途中停止して損益を評価していない試行と、損益を見て捨てた試行を分離すれば、総実行回数と統計的選択機会の混同を減らせます。
採否表には観測Sharpe、T、歪度、通常尖度、σ_SR、実効数の算定法、Nの感度範囲、DSRを並べます。許容基準が0.95なら、最も楽観的なNだけで通る候補は「合格」ではなく「独立数の仮定に依存」と記録します。DSRは補正後のSharpe値でも将来利益の事後確率でもありません。研究の探索負荷を踏まえて観測成績を疑うための、仮定付きの確率型統計量です。
相関の高い群を削る前に、台帳を二段階で照合する
具体例として、探索ログに120実行、台帳に100評価、損益列に98本があるとします。20実行がデータ取得前の失敗、2評価が完全複製なら件数差を説明できます。ただし「失敗」とされた実行で途中成績を見ていた場合は、選択機会が生じています。実行終了理由と、研究者が結果を閲覧した時点を照合し、単純に完走した列だけを母集団にしないようにします。
次に相関行列を研究期間の前半と後半で作ります。前半では高相関だった4候補が後半で分かれるなら、全期間の参加率1.37だけで冗長性を要約するのは弱い判断です。各期間の観測数、平均相関、主要固有値、参加率を並べます。期間分割は推定の不安定さを診断するためであり、実効数が最小になる期間を選ぶためではありません。
相関がほぼ1でも、違いが重要なケースがあります。二つの候補が通常日は同じ損益で、急落日だけ片方に大損があるなら、平均相関は高くても尾部リスクは同一ではありません。差分リターンの最大損失、非ゼロ日数、利益寄与を確認します。DSRの試行数診断を使って、運用上の異なるリスクまで一つの戦略へ押しつぶさないことが必要です。
比較表を確定したら台帳版を凍結し、実効数推定に都合のよい候補追加や削除を行いません。改善案が出たときは親試行IDを残して次の研究版へ進め、旧版のDSRと新版のDSRを混ぜないようにします。こうして件数の照合、相関の安定性、尾部差分という三つの確認を挟むことで、参加率の小数値だけが独り歩きするのを防げます。
監査者へ渡す最小セット
台帳だけでなく、全候補の整列済み純リターン、相関診断へ使った期間、除外・重複判定の理由、Sharpe計算の自由度と頻度、数値例を再現するコード版を一緒に渡します。入力から独立数の候補を作り、SR₀を計算し、最後にDSRを出す三段階を分離すれば、結果が違ったときに原因を追えます。
もっとも大切なのは、同じ損益を見ながら何を変更したかが消えないことです。相関が高いという理由は探索をなかったことにする免罪符ではなく、最大値補正の不確実性を検討する材料です。小数点以下のDSRを精密に表示するより、試行履歴と感度範囲を第三者が再現できる研究を完成させましょう。
コメント